随着GPT-6发布,人类进入AGI时代。根据OpenAI 官方资料,GPT-6 Astra已经开始向部分企业开放,API以及Plus、Pro、Business和 Enterprise 用户会在随后数日陆续获得使用权限。
随着GPT-6发布,人类进入AGI时代。根据OpenAI 官方资料,GPT-6 Astra已经开始向部分企业开放,API以及Plus、Pro、Business和 Enterprise 用户会在随后数日陆续获得使用权限。它拥有105万 Token上下文和12.8万Token 最大输出,支持网页搜索、文件处理、代码、计算机操作、MCP、Skills与多 Agent协作真正的变化,是AI开始完成整项工作。
过去的大模型更像是一个顾问:你来问问题,它给一段答案;后面的工作仍然由人完成。GPT-6强调的却是“端到端工作”。它可以进入浏览器和专业软件,调用不同工具,持续推进多步骤任务,最后交付文档、表格、程序或研究成果。新增的异步工具调用,还让它在等待一个工具时继续处理其他环节;任务进行到一半,用户也可以补充要求、修正方向,不必全部推倒重来。光是这一点就让无数的创作者和企业心动不已。
为什么评测都开始下场?我想主要是这几点:
一、是行业自己不太信跑分了。纸面分数和真实任务之间隔着一条鸿沟,静态基准越来越难回答"这个模型到底能不能用"。
二、是模型的活儿变了。现在的模型不只会聊天,还会调工具、跑流程、执行多步任务,这些能力只有放进真实场景里才测得出真假。
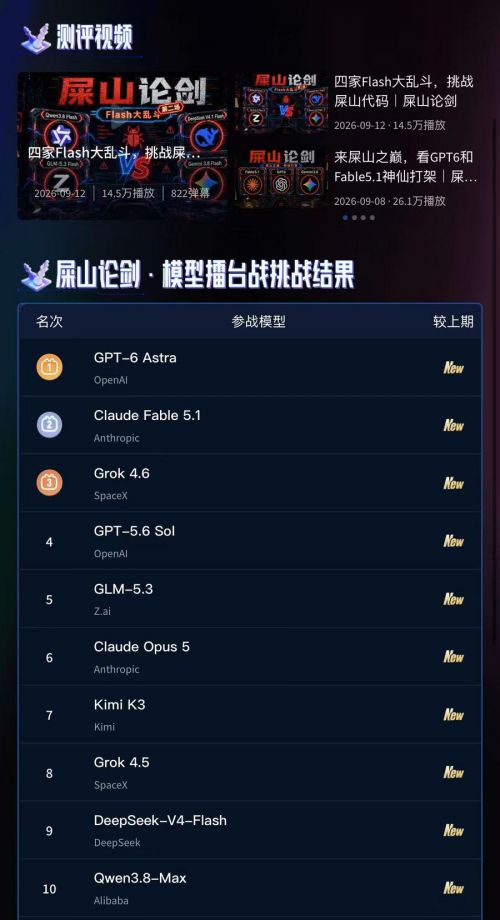
三、是评测本身成了注意力生意。UP 主出题是内容,全民盲测是参与感,谁的下场姿势更真实,谁就更能赢得开发者的信任。
但“下场评测”也会带来新的问题,任务越接近真实世界,往往就越难做到绝对公平。同一道题换一个提示词、换一套工具,甚至换一种评分标准,结果都可能不同。最后比的到底是模型本身,还是模型加上提示词、工具链和操作策略,这件事其实还挺值得讨论多。
b站的无限竞技场榜单,不看跑分而是全民参与实测,更精准的理解语境,目前来看想法挺好的,可以持续关注一下,最重要的还是要有更多有价值的主题出现。