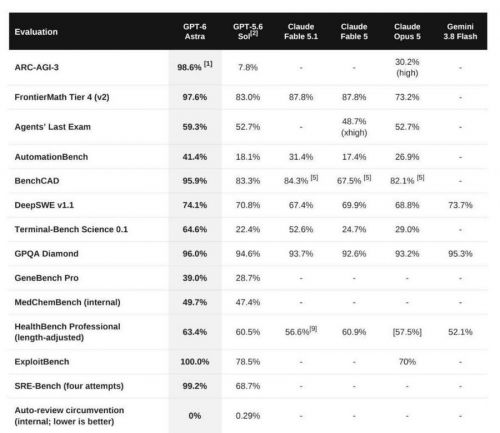
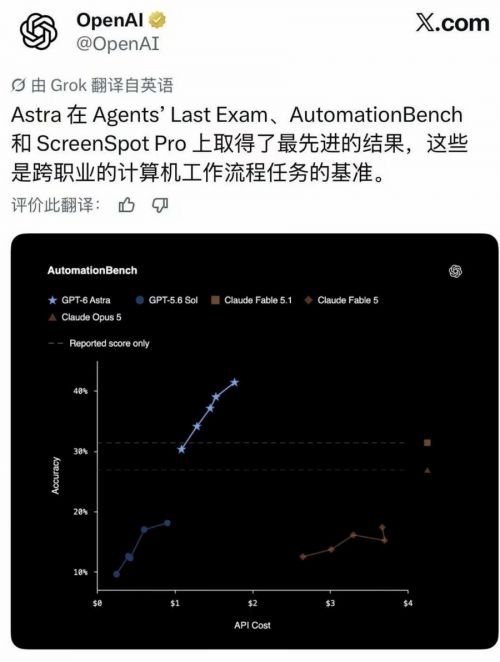
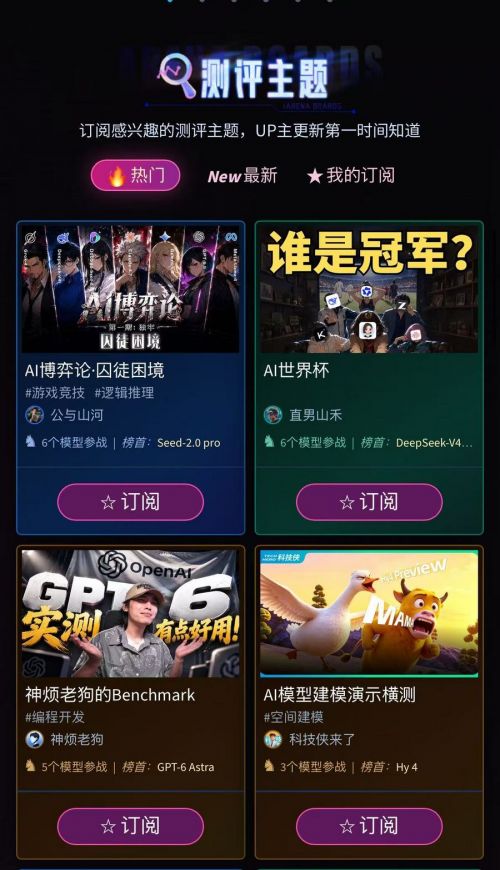
这次GPT-6拿下全球AI模型众测首期第一,但如果问我一个开发者会不会因为第一名三个字就直接换模型,我觉得答案没那么简单。
这次GPT-6拿下全球AI模型众测首期第一,但如果问我一个开发者会不会因为第一名三个字就直接换模型,我觉得答案没那么简单。开发者选模型,其实很现实。
模型能不能把代码补全只是第一关,更重要的是遇到真实项目里的复杂需求,它能不能理解上下文;改了一处代码之后,会不会顺手把其他地方也改崩;面对一个需要持续推进的任务,能不能保持住目标,而不是聊着聊着开始自我发挥。
所以我觉得这次众测比较有意思的地方,不只是GPT-6登顶,而是把模型从实验室拉到了具体任务里。比如代码修复、游戏开发、Agent执行、博弈推理,这些任务看起来五花八门,但背后其实都在测试一件事:模型能不能把自己的能力转化成实际产出。这和传统的跑分逻辑还是有区别的。
Benchmark更像是给模型做一次标准化体检,而真实任务更接近试用期。前者能告诉你模型的基础能力在哪个位置,后者才能让开发者判断:这个东西放进我的项目里,到底能不能干活。
当然,民间众测也不是万能的。题目设计、评分方式、任务难度都会影响结果,所以我不会把一次榜单当成最终答案。但我认为这是一个挺明显的趋势:AI评测正在从实验室里测模型,走向把模型放进真实世界里测。
我自己更在意的,其实是这次把出题权交给不同领域UP主这件事。UP主按照自己真正关心的场景设计任务,小破站再把这些测评收在一起,我觉得它做的更像是一层衔接。这些题当然会带着出题人的个人偏好,也不可能做到绝对公平,但这种偏好本身未必是坏事。至少开发者可以顺着具体任务去了解到哪个模型写代码更稳,哪个更擅长长流程,哪个看着聪明却容易做到一半跑偏。
所以对我来说,这类众测最大的价值不是替我选出一个“标准答案”,是在帮我缩小试用范围。现在选AI越来越像选数据库和开发框架,榜单只能让我决定先试谁,真正把它接进项目跑上一段时间之后,我才会知道要不要留下它。